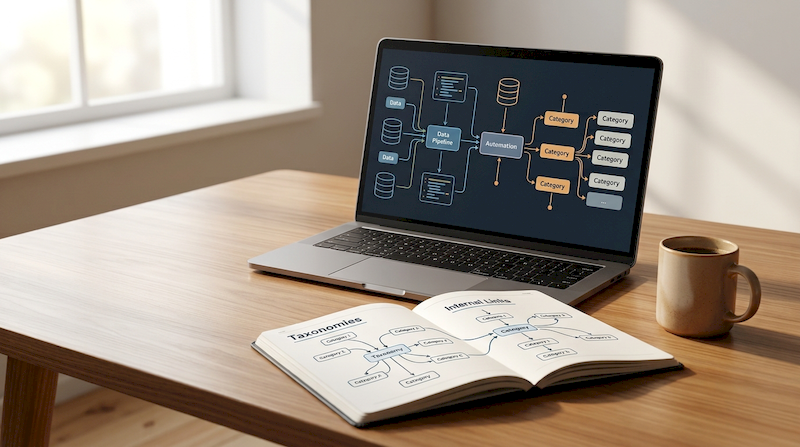
静的サイトジェネレーター(SSG)として高いパフォーマンスを誇るAstroを用いたサイト運営において、記事数や専門用語が増加するにつれて直面するのが「内部データ処理の煩雑化」と「回遊性を左右するカテゴリ設計」という2つの課題です。本記事では、複数スクリプトのパイプライン統合による運用の安定化と、NDC(日本十進分類法)を補完する直感的なtaxonomy(カテゴリ)機能の実装プロセスを、開発現場の実例に沿って詳しく解説します。
辞書型サイトにおけるサイト構造と自動化の重要性
専門用語や概念を体系的に整理して発信する辞書型サイトやナレッジベースは、ブログのような時系列のコンテンツとは異なり、情報同士の有機的な結びつきがサイトの価値を大きく左右します。コンテンツ数が増加すればするほど、手動管理の限界が訪れ、ビルドパイプラインの整備と堅牢な情報アーキテクチャの構築が不可欠になります。
静的サイトにおける運用の壁と手動オペレーションのリスク
静的サイトは表示速度やセキュリティの面で極めて優れた利点を持つ一方、データの整合性をビルド時にすべて解決しなければならないという特性を持っています。辞書型サイトでは、以下のような処理が頻繁に発生します。
- 記事本文に含まれる用語を検出して自動的にハイパーリンクを付与する「リンク生成処理」
- サイト全体の用語構造や親子関係を索引化する「辞書マップ作成処理」
- 新規追加した用語に適切な参照先が存在するかを検証する「未リンクチェック処理」
これらの処理を開発者が手動で個別にスクリプト実行していると、実行順序の誤りによる参照先の不整合や、スクリプトの実行漏れによるリンク切れなどの人為的ミス(ヒューマンエラー)が必然的に発生します。運用の自動化は、単なる効率化だけでなく、サイトの品質と信頼性を保つための生命線です。
内部リンクとディレクトリ階層が検索評価に与える影響
検索エンジンは、サイト内のリンク構造(内部リンク)とURL階層を辿ることで、各ページの専門性やトピックの関連性を把握します。孤立したページ(オーファンページ)が存在すると、クローラーによる巡回効率が低下するだけでなく、ユーザーも次の情報へスムーズに遷移できません。
論理的な内部リンク網が張り巡らされ、整ったディレクトリ階層を持つサイトは、ユーザーの滞在時間向上と離脱率低下につながり、結果として検索品質の向上にも寄与します。そのため、データ構築の基盤となる自動化スクリプトとカテゴリ構造の整合性を保つことが極めて重要になります。
Amazonのアソシエイトとして、当メディアは適格販売により収入を得ています。
作業効率と保守性を高める「3つのスクリプト統合」
開発効率の向上と運用の堅牢化を達成するため、個別運用されていたデータ処理プロセスを1本の統合パイプラインへと再構築しました。これにより、コマンド1つで前提条件を満たしたビルド準備が整う環境を実現しています。
リンク生成・辞書マップ作成・未リンクチェックの一元化
統合されたパイプラインでは、処理の依存関係を考慮して以下の順序で厳密にシーケンス制御を行っています。
- リンク生成スクリプト:全記事のテキストを走査し、登録済み用語とのマッチングを行って本文内のリンクマークアップを動的に構成します。
- 辞書マップ作成スクリプト:更新されたリンク構造と用語データを集約し、サイト全体のインデックスツリー(サイト内辞書マップ)をJSONなどのデータ形式で再生成します。
- 未リンクチェックスクリプト:生成されたマップをもとに、リンク先が存在しない不正なURL参照や、未定義の用語への言及がないかを網羅的に検証します。
この順序が一貫して維持されることで、「マップが存在しない状態で検証が走る」といった依存関係の崩れによる不具合を完全に排除できます。
1コマンド化によるヒューマンエラー防止と再現性の担保
複数の処理をnpm-run-allやシェルスクリプトを用いて統合し、開発環境および本番デプロイ前のCI/CD環境で共通の1コマンドとして実行できるように設定しました。作業者が手順書を見ながら複数コマンドを順に入力する必要がなくなり、再実行時にも常に同一の処理結果が得られる「再現性」が担保されます。
実行パイプラインの比較(個別実行 vs パイプライン化)
スクリプトの運用形態によるメリット・デメリットの比較は以下の通りです。サイトの規模や更新頻度に応じて適切な運用形態を選択する基準として参考にしてください。
| 比較項目 | スクリプト個別実行(従来方式) | パイプライン統合実行(改善後) | 向いている運用スタイル |
|---|---|---|---|
| 作業工数・手間 | 処理ごとにターミナル入力が必要で煩雑 | 1コマンド入力のみで全自動完了 | 複数人が関わる開発や高頻度更新 |
| 順序ミスのリスク | 実行順序を誤るとデータ不整合が発生 | シーケンス制御により順序ミスが起きない | 品質管理を厳密に行いたいサイト |
| エラーの検知 | 途中のエラーを見落としやすい | 途中エラーで処理が自動停止し即検知可能 | デプロイ自動化(CI/CD)環境 |
| 適した対象者 | スクリプト単体のデバッグ作業時 | 日々の記事執筆・本番ビルド作業時 | 実務レベルの継続的なメディア運営 |
ユーザー体験とSEOを両立するtaxonomy(カテゴリ)機能の設計
サイト内の情報を整理する際、どのような分類基準を用いるかはユーザーの探しやすさに直結します。本サイトでは学術的な体系性を持つNDC(日本十進分類法)を採用してきましたが、実用性を高めるために新たなtaxonomyの導入を行いました。
NDCコード分類の利点と直感的カテゴリの必要性
NDCは、知識を「0 総記」「5 技術・工学」といった体系的な数値コードで厳密に階層化できる優れた分類法です。専門的な情報の網羅性や学術的な位置づけを整理する上では極めて強力な基盤となります。
しかし、一般的な検索ユーザーが「AI」や「機械学習」の用語を探す際、「548(情報工学)」などのコードを意識して検索することは稀です。ユーザーが日常的に用いる自然な言葉で探せる「直感的なカテゴリ分類」が存在しなければ、サイト内の回遊ハードルが高くなってしまいます。
二重構造(体系的分類×実践的キーワード)による網羅性の強化
そこで、「NDCコードによる縦軸の階層分類」をサイトの基盤として維持しつつ、横断的なトピックを束ねる「taxonomy(タグ・テーマ分類)という横軸」を導入する二重構造の設計を採用しました。
たとえば「AI」というtaxonomyを新設することで、NDC上で工学、倫理、ビジネスなどの異なる分類記号に分散していた関連用語を、ユーザー視点の「AI」という単一の切り口で一括して提示できるようになります。この設計により、検索意図に沿ったランディングページとしても機能し、サイト全体の情報網羅性とSEO効果を同時に強化することが可能になります。
Astroでのtaxonomy実装ステップとデータ構造の拡張
Astroでコンテンツコレクションを運用しながら柔軟なカテゴリ分類を実現するには、スキーマ定義からルーティング、レイアウトの統合までを一貫したフローで進める必要があります。ここでは、実務に即した具体的な4つの実装ステップを整理して解説します。
ステップ1:taxonomyディレクトリとカテゴリファイルの設計
まずは、カテゴリのメタデータ(表示名、スラッグ、説明文など)を一元管理するための専用ディレクトリを整備します。src/content/taxonomy/配下に各カテゴリに対応するMarkdownまたはJSONファイルを配置する構成が一般的です。
src/
└── content/
    ├── dictionary/     # 用語データ
    │   ├── machine-learning.md
    │   └── neural-network.md
    └── taxonomy/       # カテゴリデータ
        └── ai.md
カテゴリごとに個別ファイルを用意しておくことで、単なるタグ文字列の羅列に留まらず、カテゴリごとの固有説明文やメタ情報を柔軟に持たせることができるようになります。
ステップ2:content.config.ts(Schema定義)の安全な拡張
次に、Astroのコンテンツコレクション機能を用いて、データ構造を型安全に定義します。辞書側の各用語がどのtaxonomyに属しているかを定義するため、Zodスキーマを拡張します。
import { defineCollection, reference, z } from 'astro:content';

const dictionary = defineCollection({
  type: 'content',
  schema: z.object({
    title: z.string(),
    description: z.string(),
    ndc: z.string(),
    taxonomies: z.array(reference('taxonomy')).default([]),
  }),
});

const taxonomy = defineCollection({
  type: 'content',
  schema: z.object({
    name: z.string(),
    description: z.string().optional(),
  }),
});

export const collections = { dictionary, taxonomy };
reference()を利用してtaxonomyコレクションへの参照を明示することで、存在しないカテゴリIDが指定された場合にビルド時に検知できるようになり、データの整合性が強力に保護されます。
ステップ3:動的ルーティング([taxonomy].astro)と一覧ページの構築
各カテゴリに属する用語を一覧表示するため、動的ルーティングを活用したページを実装します。src/pages/taxonomy/[id].astroを作成し、getStaticPaths関数を用いて静的パスを生成します。
---
import { getCollection } from 'astro:content';
import BaseLayout from '../../layouts/BaseLayout.astro';
export async function getStaticPaths() {
const allTaxonomies = await getCollection('taxonomy');
const allTerms = await getCollection('dictionary');
return allTaxonomies.map((cat) => {
const filteredTerms = allTerms.filter((term) =>
term.data.taxonomies.some((ref) => ref.id === cat.id)
);
return {
params: { id: cat.id },
props: { category: cat, terms: filteredTerms },
};
});
}
const { category, terms } = Astro.props;
---
{category.data.name}
{category.data.description}
{terms.map((t) => (
-
{t.data.title}
))}
これにより、/taxonomy/ai/といったURLで該当カテゴリの用語一覧が自動生成され、SEOに適したランディングページとして機能します。
ステップ4:共通Layoutコンポーネントによるデザイン統一
新規追加した一覧ページは、作成直後だとCSSや共通パーツが適用されず表示が崩れてしまうことがあります。既存の共通レイアウトコンポーネント(例:BaseLayout.astroなど)で全体を包み、ヘッダー、フッター、パンくずリスト、サイドバーの構造を既存ページと統一させます。これにより、サイト全体の視覚的な調和とユーザーの操作性が保たれます。
開発中につまずきやすいエラーと実践的な切り分け手法
静的ビルドツールとTypeScriptを組み合わせた環境では、ビルド時に厳密なチェックが走るため、軽微なデータ不備でも処理が中断されます。開発時によく遭遇する代表的なエラーとその対処法をまとめました。
Markdown内の不正リンク検出と文字列バリデーション
ビルドエラーの原因として特に多いのが、Markdown本文やフロントマター内のリンク記述の不備です。相対パスの指定ミスや、本来文字列(string)であるべきプロパティに数値やオブジェクト、undefinedが渡されている場合、レンダラーが解析に失敗して停止します。
対処法として、スクリプト側でURLやリンク文字列を渡す際に厳密なバリデーション(例:typeof url === 'string'の判定や、スキーマ側での明示的な文字列検証)を挟むことが極めて有効です。パイプライン内の検証ステップで事前に不正な値を検知し、ログに問題箇所のファイル名を出力させる設計にしておくと、修正作業がスムーズになります。
TypeScriptの型不一致(Type Mismatch)を未然に防ぐアプローチ
スキーマを拡張した直後は、既存のコンテンツファイルの中に新スキーマを満たさないデータが残っているため、型チェック(astro checkなど)で不一致エラーが頻発しやすくなります。これを防ぐためには、スキーマ定義の段階で.optional()や.default([])を活用し、段階的に移行できる猶予を持たせることが実務上のポイントです。
よくある質問(FAQ)
Q1. NDCコードによる分類があるのに、なぜ追加のカテゴリ(taxonomy)が必要なのですか?
NDCは体系的で網羅的な分類に優れている反面、専門的であるため、一般的なユーザーの日常的な検索語句と乖離しやすい側面があります。検索されやすいキーワードに合わせた実用的なカテゴリを追加し、二重構造で整理することで、ユーザーの探しやすさと検索流入の双方を向上させることができます。
Q2. スクリプトのパイプライン化にはどのようなツールを使うのが適切ですか?
小規模から中規模の構成であれば、npm-run-all(またはnpm-run-all2)を用いてpackage.json内で直列実行(run-s)を定義する方法が手軽で確実です。より複雑な条件分岐やファイル監視が必要な場合は、Node.jsのスクリプトから子プロセスを制御する構成や、シェルスクリプトによる管理が適しています。
Q3. スキーマ拡張を行うと、既存の記事データすべてを一度に修正する必要がありますか?
新設したフィールドを必須(required)にしてしまうと全修正が必要になりますが、スキーマ定義時に.default([])や.optional()を設定しておけば、既存記事のビルドを壊すことなく、段階的に新しいカテゴリ情報を紐づけていくことが可能です。
Q4. 動的ルーティングの生成によってビルド時間が大幅に増える心配はありませんか?
Astroは静的ビルドの最適化が非常に優れており、数百から数千ページ規模の辞書型サイトであっても、適切なコレクション取得処理を行っていれば高速にビルドが完了します。不要な全件取得の多重ループを避け、getStaticPaths内で効率的にデータをマッピングすることがパフォーマンス維持の鍵となります。
まとめと今後の展望
今回の改善作業により、これまで個別に実行していたデータ処理スクリプトが一本のパイプラインとして統合され、運用の安全性と再現性が飛躍的に向上しました。さらに、学術的なNDC分類を基盤としつつ、実用的なtaxonomy(カテゴリ)機能を導入したことで、情報アーキテクチャの柔軟性が大きく広がりました。
今後は、カテゴリ表示名の最適化や、一覧ページにおける解説文の充実、関連用語への回遊導線の強化を進めることで、訪問者にとってより使いやすく、検索エンジンからも高く評価される強固なナレッジベースへと育てていくことが重要になります。堅牢な内部構造を土台として、継続的なコンテンツ拡充を進めていきましょう。