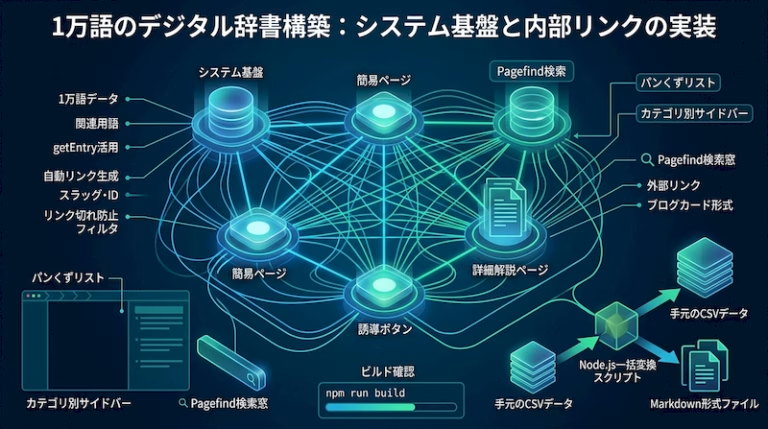
辞書サイトやオウンドメディアを運営する中で、用語解説ページと詳細な特集記事の間で読者が迷子になっていませんか?本記事では、Astro 5.0の「Content Layer API」を活用して辞書データと解説記事を相互に紐付ける設計手法から、Zodによる型安全なスキーマ定義、そしてパンくずリストの統一やレイアウト設計までを体系的に解説します。
大規模なコンテンツを抱えるWebサイトでは、内部構造の最適化とコンポーネントの共通化が、長期的な運用効率と読者の回遊性を左右します。実際の開発現場で直面しやすいTypeScriptの型エラーやデータ構造の不整合を回避し、メンテナンス性とユーザー体験を両立する堅牢なサイト基盤を構築していきましょう。
1. 辞書サイトにおける「用語詳細」と「解説記事」の紐付け設計
専門用語を扱うWebサイトにおいて、単語の意味を端的に伝える「用語辞書データ」と、背景や具体例を深く掘り下げる「特集解説記事」は、それぞれ異なる役割を持っています。これらを適切に分離しながらもシステム上で強固に連携させる設計は、サイトの価値を高める重要な土台となります。
1-1. 用語集と深掘り記事を分離・連携させるサイトアーキテクチャ
1万語を超えるような用語辞書(dictionary)と、編集者が執筆する解説記事(articles)を同一のデータ構造で管理しようとすると、フロントマターの項目が肥大化し、スキーマの管理が破綻しやすくなります。辞書データは語義、品詞、分類コードといった定型情報が中心であるのに対し、解説記事は導入文、章立て、図解、外部リンクなど非定型でリッチな要素を多く含むためです。
そのため、データコレクションとしてはdictionaryとarticlesを明確に分離し、双方のキー情報(スラッグや用語ID)を介して動的にリレーションを結ぶアーキテクチャが適しています。これにより、辞書側の軽量性を維持したまま、解説記事側から必要な用語情報を自在に参照できる柔軟性が確保されます。
1-2. getStaticPathsにおけるコレクション間データ連携ロジック
静的サイト生成(SSG)を行うAstroにおいて、動的ルーティングを制御するgetStaticPathsはデータ連携の要です。解説記事のページを生成する際、関連する用語データをビルド時に先回りして取得・結合しておくことで、高速なページレンダリングが可能になります。
具体的には、解説記事のフロントマターに設定された関連用語識別子(related_terms)をトリガーとし、getCollection('dictionary')から該当する用語オブジェクトを抽出してpropsとして各ページに渡す実装を行います。
// src/pages/articles/[...slug].astro の実装例
import { getCollection } from 'astro:content';

export async function getStaticPaths() {
  const articles = await getCollection('articles');
  const allTerms = await getCollection('dictionary');

  // 用語データをIDまたはslugをキーにしたMap形式に変換して探索を高速化
  const termMap = new Map(allTerms.map((term) => [term.id, term]));

  return articles.map((article) => {
    // 記事に関連付けられた用語の完全なデータを抽出
    const resolvedRelatedTerms = (article.data.related_terms || [])
      .map((termId) => termMap.get(termId))
      .filter((term): term is NonNullable<typeof term> => Boolean(term));

    return {
      params: { slug: article.id },
      props: { article, resolvedRelatedTerms },
    };
  });
}

const { article, resolvedRelatedTerms } = Astro.props;
このアプローチを採用することで、テンプレート側では追加の非同期通信を行うことなく、ビルド済みのリレーション情報を使って「この記事で解説している用語」を正確にレンダリングできます。
1-3. ユーザー回遊率とクローラビリティを向上させる内部リンクの価値
用語詳細ページから「この記事について詳しく読む」という文脈で解説記事へ誘導し、逆に解説記事内からは登場する専門用語の辞書ページへとリンクを戻す双方向の導線設計は、サイト全体の回遊率(セッションあたりの閲覧ページ数)を大きく向上させます。
また、検索エンジンのクローラーに対しても、トピックの関連性や親子関係を論理的に伝える強力なシグナルとなります。孤立したページ(いわゆる孤立ノード)を排除し、サイト全体をセマンティックなネットワークとして結ぶことで、専門性と網羅性を兼ね備えたWebサイトとしての評価基盤が整います。
Amazonのアソシエイトとして、当メディアは適格販売により収入を得ています。
2. 最新Astro 5.0構成への適応:src/content.config.tsの実装
Astro 5.0で導入された「Content Layer API」は、データ管理の柔軟性を飛躍的に高めました。従来のsrc/content/config.tsからsrc/content.config.tsへの移行に伴い、型安全性を維持しながらイレギュラーなデータ入力を吸収するスキーマ設計が求められます。
2-1. loader: globを用いた新しいコンテンツロード機構
従来の暗黙的なディレクトリ読み込みに代わり、Astro 5.0では明示的なローダー関数が採用されました。ローカルのMarkdownやMDXファイルを読み込む際は、astro/loadersから提供されるglobローダーを使用します。
基準ディレクトリ(base)と対象パターン(pattern)を明示的に指定することで、サブディレクトリ構造を持つ複雑なプロジェクトであっても、予期せぬファイルの誤認や取得漏れを防ぎ、高速なビルドを実現できます。
2-2. Zodスキーマによる型安全の強化(ndc_code・related_terms)
コンテンツの整理において、分類コードや相互リンク情報は欠かせません。記事コレクション(articles)のスキーマ定義に、日本十進分類法を意識したndc_codeや、関連用語の配列であるrelated_termsを型定義として組み込みます。
これにより、フロントマターの入力ミスやスペルミスが存在する場合にビルドプロセスが即座に検知し、未然にレンダリングエラーを防ぐことが可能になります。
2-3. 日付の柔軟なパース(z.unionとtransform)と外部リンクのオプショナル設計
過去に作成した大量のMarkdownファイルを移行する際、フロントマターの日付フォーマットが統一されておらず(例:2026-09-23というYAMLの日付型と、"2026-09-23"という文字列型が混在)、Zodのバリデーションエラーでビルドが止まるケースがあります。
この課題は、z.unionとtransformを組み合わせて、文字列型であっても自動的にJavaScriptのDateオブジェクトへ正規化する処理を組み込むことで解消できます。また、外部リンク情報に関しても、サイト名(site_name)などが未入力でも破綻しないようオプショナル設計を施します。
// src/content.config.ts の実装例
import { defineCollection, z } from 'astro:content';
import { glob } from 'astro/loaders';

// 日付データを柔軟にパースするカスタムスキーマ
const flexibleDateSchema = z.union([z.date(), z.string()]).transform((val) => {
  return val instanceof Date ? val : new Date(val);
});

// 解説記事コレクションの定義
const articles = defineCollection({
  loader: glob({ pattern: '**/*.{md,mdx}', base: './src/content/articles' }),
  schema: z.object({
    title: z.string(),
    description: z.string().optional(),
    date: flexibleDateSchema,
    ndc_code: z.string().optional(),
    related_terms: z.array(z.string()).default([]),
    external_links: z
      .array(
        z.object({
          url: z.string().url(),
          title: z.string(),
          site_name: z.string().optional(),
        })
      )
      .optional()
      .default([]),
  }),
});

// 用語辞書コレクションの定義
const dictionary = defineCollection({
  loader: glob({ pattern: '**/*.{md,mdx}', base: './src/content/dictionary' }),
  schema: z.object({
    term: z.string(),
    reading: z.string().optional(),
    category: z.string(),
    description: z.string(),
  }),
});

export const collections = { articles, dictionary };
このように柔軟性と厳密さを両立させたスキーマを定義することで、既存データの整合性を保ちながら、安全にシステムを運用できるようになります。
3. デザインの一貫性確保とUIコンポーネントの再配置
データパイプラインの整備と並行して、訪問者が快適にサイト内を巡回できるUI(ユーザーインターフェース)の構築も欠かせません。各ページでデザインのトーンやナビゲーション構造が異なっていると、読者に不要な認知的負荷を与え、サイト全体の信頼性を損なう要因となります。
3-1. ol/li構造によるパンくずリストのセマンティックな統一
Webサイトの現在位置を示す「パンくずリスト(Breadcrumb)」は、これまでページごとに異なるHTMLマークアップが適用されがちでした。今回の改修では、すべてのテンプレートにおいて<nav>内に番号付きリストである<ol>および<li>を用いた階層構造へと統一しました。
<!-- 統一されたパンくずリストのマークアップ例 -->
<nav aria-label="Breadcrumb" class="breadcrumb-nav">
  <ol itemscope itemtype="https://schema.org/BreadcrumbList">
    <li itemprop="itemListElement" itemscope itemtype="https://schema.org/ListItem">
      <a itemprop="item" href="/"><span itemprop="name">ホーム</span></a>
      <meta itemprop="position" content="1" />
    </li>
    <li itemprop="itemListElement" itemscope itemtype="https://schema.org/ListItem">
      <a itemprop="item" href="/category/007/"><span itemprop="name">情報科学(NDC 007)</span></a>
      <meta itemprop="position" content="2" />
    </li>
    <li itemprop="itemListElement" itemscope itemtype="https://schema.org/ListItem">
      <span itemprop="name" aria-current="page">用語解説</span>
      <meta itemprop="position" content="3" />
    </li>
  </ol>
</nav>
このようにセマンティックなHTML構造を採用し、構造化データ(Schema.org)を付与することで、検索エンジンのクローラーがサイトの階層関係を正確に把握できるようになります。同時に、スクリーンリーダーなどの支援技術を利用するユーザーに対しても、適切なナビゲーション情報を提供できます。
3-2. サイドバー検索機能の復旧とクライアントスクリプトの配置
サイトの大規模化に伴い、読者が目的の用語に即座にアクセスできるサイト内検索は必須の機能です。システム更新時に一時的に非表示となっていたPagefindベースの検索窓コンポーネントを再配置しました。
Astroにおける静的検索機能の統合では、コンポーネントのテンプレート内に検索窓を描画するDOMノードを用意し、クライアントサイドで動作する検索スクリプトを安全に初期化する必要があります。不要なJavaScriptの再実行や競合を防ぎ、どのページからでも高速に入力・候補表示が行える検索体験を復元しました。
3-3. ユーザビリティと収益化を両立する広告ユニットの再配置基準
持続可能なサイト運営を行うための広告配信ユニット(忍者AdMaxや楽天モーションウィジェット等)についても、ページ上部・下部およびサイドバーの適切な位置へと再配置を行いました。
広告の配置において最も重視すべきは、読者が求めるメインコンテンツの閲覧を妨げない「広告バランス」の維持です。ファーストビューを広告だけで埋め尽くすような過度な配置は、ユーザーの離脱を招くだけでなく、品質評価基準の観点からも望ましくありません。また、広告枠には「スポンサーリンク」や「広告」といった識別表示を明瞭に付与し、景品表示法の指定告示(ステマ規制)をはじめとする関係法令に適合した透明性の高い運用を徹底しています。
4. コンポーネントとレイアウトの明確な役割分担
Astroの強みであるコンポーネント指向を活かすためには、「どのファイルにどの責務を持たせるか」という役割分担の整理が重要です。不要なコンポーネントを統廃合しつつ、サイト独自の価値を生み出す中核ファイルの位置づけを明確にしました。
4-1. BlogCard.astroの継続採用とリッチスニペット的役割
外部の参考文献や関連Webサイトへのリンクを表示する際、単なるテキストリンクでは視覚的な魅力やリンク先の概要が伝わりにくい課題があります。これに対し、サムネイル画像、タイトル、概要文、ドメイン名をカード形式で美しくまとめるBlogCard.astroの継続採用を決定しました。
リッチなカード形式でリンクを提示することは、読者にとってリンク先の内容をあらかじめ予見できる安心感につながります。内部の解説記事同士の誘導にもこのカードコンポーネントを活用することで、直帰率を抑え、深い理解を促す回遊ルートを形成できます。
4-2. 大規模データ表示を支えるDictionaryLayout.astroの設計思想
1万語を超える膨大な用語データを効率的にレンダリングするため、専用の共通テンプレートとしてDictionaryLayout.astroを位置づけています。一般的なブログ記事と辞書ページでは、求められる情報密度やレイアウトが根本的に異なります。
本レイアウトでは、以下の要素をテンプレート側で担保しています。
- 語義、品詞、読み仮名、NDC分類コードなどの基本情報ブロックの定型表示
- Cocoonテーマの設計思想を継承した、可読性の高い本文スタイルとタイポグラフィの適用
- サイドバー、目次、関連記事(解説記事)への動的リンク領域の効率的な配置
レイアウト側に共通の表示ルールを集約しておくことで、個々のMarkdownファイルは純粋なテキストデータのみに集中でき、将来的なデザイン変更やデータ拡張にも柔軟に対応できる構造が実現します。
4-3. Astroサイト構造設計アプローチの比較
コンテンツサイトの規模や運用目的に応じた、Astroにおけるデータ管理とレイアウト設計のアプローチを比較しました。
| 設計アプローチ | 主な特徴と構造 | メリット | 向いているサイト規模・用途 |
|---|---|---|---|
| 単一コレクション運用 | 全Markdownを1つのフォルダで管理し、タグ等で区別 | 構造がシンプルで初期構築が最も容易 | 小規模ブログ、単一テーマの個人サイト(〜数百記事) |
| 役割分離コレクション(採用方式) | 辞書(定型)と解説(非定型)を別コレクションで管理し動的結合 | スキーマの肥大化を防ぎ、型安全性と回遊導線を両立 | 大規模辞書サイト、ナレッジベース、専門ポータル(数千〜数万件規模) |
| 完全動的外部API連携 | ヘッドレスCMSや外部DBからSSR/ビルド時に取得 | ノンエンジニアとの分業や複数プラットフォーム配信が容易 | 頻繁に更新が発生するニュースメディア、大規模ECサイト |
5. 辞書サイトのメンテナンスと高速化に向けた今後の展望
土台となる型定義や共通パーツの整理が完了したことで、今後のサイト運営における拡張性が大幅に向上しました。今後はさらなる価値提供に向けて、二つの柱を軸に改善を進めていく方針です。
5-1. 型安全な基盤がもたらす長期的な保守性の向上
Astro 5.0とZodの連携によって確立された型安全な基盤は、予期せぬビルドエラーやリンク切れを未然に防ぐ強力な防御壁となります。今後、用語データが数万件規模へとスケールしていった場合でも、スキーマ検証を通じてデータの整合性を常に担保できます。
また、分類コード(NDC)に基づいたカテゴリツリーの自動再編や、関連語句の相互参照ネットワークの自動生成など、より高度なアルゴリズムの導入も容易になります。
5-2. 表示速度改善とコンテンツ拡充に向けたステップ
基盤が整った次のフェーズでは、Core Web Vitalsを意識した表示スピードの極限までの最適化に取り組みます。不要なCSS/JSの削減、画像の次世代フォーマット(WebP/AVIF)最適化、Pagefindインデックスのロードタイミング調整などを進め、瞬時にページが表示される読書体験を追求します。
並行して、各専門用語に対応する深掘り解説記事の執筆を強化し、単なる語義の確認にとどまらない、知的探求を満たすポータルサイトとしての完成度を高めていきます。
6. Astroサイト構築に関するよくある質問(FAQ)
Q1. 異なるコレクション間で双方向リンクを貼る際のベストプラクティスは何ですか?
A. 動的ルーティングを担うgetStaticPaths内で双方のコレクションをgetCollectionし、IDやスラッグをキーにしたMapオブジェクトを作成して探索・結合するのが最も効率的です。テンプレート内での無駄な全件走査を防ぎ、ビルドパフォーマンスを損なわずにリレーションを構築できます。
Q2. フロントマターの日付処理でZodのバリデーションエラーが出やすい理由は?
A. YAMLパーサーが日付文字列(例: “2026-09-23″)を文字列型として解釈する場合と、Dateオブジェクトとして解釈する場合が混在するためです。z.union([z.date(), z.string()]).transform(...)を用いて、どちらの型で渡されても確実にJavaScriptのDateインスタンスへと正規化する処理を入れることで回避できます。
Q3. 1万語を超える大規模な用語集をAstroでビルドする際の注意点は?
A. 大量ページの静的HTML生成に伴うメモリ枯渇やビルド時間の増大に注意が必要です。不要なアセットのバンドルを避け、コンポーネント内での重い同期処理を排除すること、またContent Layer APIのインクリメンタルなキャッシュ機構を適切に活用することが推奨されます。
Q4. パンくずリストをol/liタグで構造化するメリットは何ですか?
A. 単なるdivやspanの羅列と異なり、順序を持ったリストとして階層関係がブラウザや検索エンジンに正しく伝わる点です。さらにSchema.orgのBreadcrumbList構造化データを埋め込むことで、検索結果のスニペットにパンくず階層が表示されやすくなり、クリック率の向上が期待できます。
7. まとめ:堅牢なデータ構造が優れたユーザー体験を創出する
Astro 5.0へのアップデートを契機としたプロジェクト内部構造の整理は、単なるコードの美観改善にとどまらず、サイトの回遊性、保守性、そして将来の拡張性を底上げする重要なマイルストーンとなりました。
辞書データと解説記事のシームレスな紐付け、Zodによる柔軟かつ厳格な型安全の確保、そして統一されたUIコンポーネントの配置は、すべて訪問者が求める知識へと迷わず到達するための基盤です。確固たるシステム基盤の上に質の高いコンテンツを積み重ね、読者にとって真に価値ある情報ポータルを育てていきましょう。