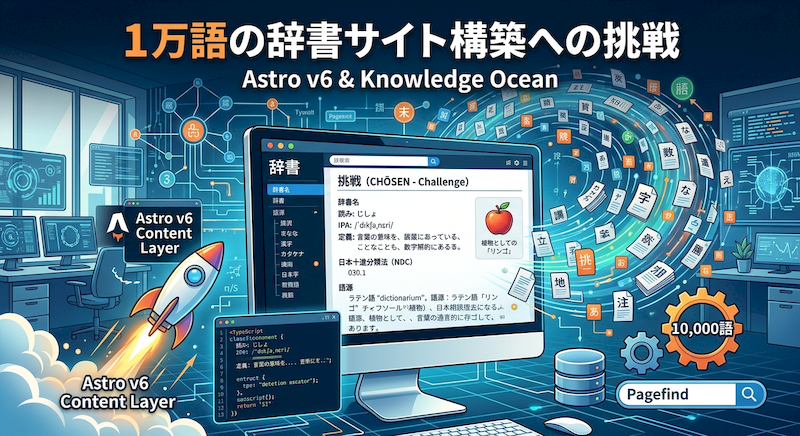
Web上に無数に存在する情報の中で、誰にとっても分かりやすく、学術的にも信頼できる知識の集積地を作りたい――そんな思いから、私は「1万語規模のデジタル辞書サイト」の個人開発に着手しました。単なる思いつきではなく、インターネットの黎明期にあった「知的好奇心を刺激するハイパーリンクの海」を、現代のモダンなWebフロントエンド技術で再構築したいという構想に基づいた挑戦です。しかし、実際に手を動かし始めてみると、1万語というスケールがもたらすデータモデリングの複雑さ、フレームワーク選定の壁、そして次世代ツールへの移行に伴う予期せぬビルドエラーなど、幾重もの技術的なハードルが次々と立ちはだかりました。
特に、1万ページという膨大な静的ページを破綻なく生成し、瞬時のページ遷移と快適な検索体験を両立させるためには、従来のWebサイト制作とは全く異なるアーキテクチャが求められます。課題を一つずつ紐解き、試行錯誤を重ねることで、辞書サイトとしての確固たる基盤(強固な器)を構築することに成功しました。本記事では、1万語規模のデジタル辞書を作るにあたって決定した「15の必須項目」による情報設計や、最新の「Astro v6」を活用した高速なサイト構築の裏側、Content Layerへの移行に伴うTypeScript型エラーの解消法、PowerShell環境でのトラブルシューティング、そしてNDC(日本十進分類法)第10版に基づいた実証実験まで、大規模Web制作のノウハウを余すところなくお伝えします。
1万語規模のデジタル辞書サイト構築へ向けた第一歩
インターネット上には既に無数の辞書や用語集、個人ブログが存在します。その中で、あえて個人開発で「1万語」という途方もない規模を目指すのはなぜでしょうか。それは、単一の専門用語集では成し得ない「知識ネットワークの網羅性」と、ユーザーおよび検索エンジン(SEO)、さらには現代のAI検索クローラーに対する圧倒的な情報価値を両立させたいと考えたからです。
なぜ個人で「1万語」というスケールにこだわるのか?
単一のテーマに特化した小規模な用語集であれば、数十語から数百語程度でも十分に成立します。しかし、知識体系そのものを俯瞰できるポータルサイトを目指す場合、語彙数の多さはそのままサイト全体のドメインパワーや回遊性に直結します。たとえば「哲学」の用語を調べていた読者が、関連する「言語学」や「情報科学」の概念へと自然に導かれるような体験は、網羅的な語彙数があって初めて実現します。
関連する用語同士が緻密な内部リンクによって蜘蛛の巣のように結びつくことで、読者は知的好奇心の赴くままに知識を深めることができます。また、検索エンジンにとっても、サイト全体が巨大なトピッククラスターとして認識され、各ページの専門性・網羅性が相乗効果を発揮して検索順位が底上げされるという大きなSEOメリットが存在します。
動的CMS(WordPress)の限界と静的サイトジェネレーター(SSG)の必然性
しかし、ページ数が1万件を超えるWebサイトを構築する場合、設計段階で最も慎重に検討しなければならないのが「アーキテクチャの選定」です。ブログやメディア構築で広く使われているWordPressをはじめとする動的CMS(アクセスごとにPHPが動き、リレーショナルデータベースに問い合わせを行う仕組み)は、以下のような深刻な課題を抱えています。
- サーバー負荷と表示速度の低下: ページ数が1万を超え、かつ同時アクセスが増加すると、データベースのコネクション枯渇やキャッシュの断片化が発生し、TTFB(最初の1バイトが届くまでの時間)が著しく悪化します。
- インフラコストの増大: 高トラフィックに耐えうる高性能なデータベースサーバーやキャッシュサーバー(Redis、Memcached等)を常時運用する必要があり、個人開発の枠を超えるサーバー費用が発生します。
- セキュリティリスクの増大: プラグインの脆弱性やSQLインジェクションなど、動的CMS特有の攻撃対象領域(アタックサーフェス)が常に存在し、定期的な保守・アップデート作業が開発者の負担となります。
- 手作業によるコンテンツ管理の限界: 管理画面から1ページずつ投稿・編集を行う運用スタイルでは、1万ページのデータの一括更新やフォーマット変更、メタデータの再付与に途方もない工数がかかります。
これらの課題を根本から解決するのが、「静的サイトジェネレーター(SSG: Static Site Generator)」によるアプローチです。コンテンツをローカルやCI環境で事前にHTML/CSSとしてビルドし、世界中に分散配置されたCDN(Content Delivery Network)から配信することで、サーバー負荷を完全にゼロにし、世界最高峰の表示速度を実現できます。「超高速な表示速度」と「構造化されたデータの一括管理」を両立させる基盤こそが、1万語の辞書サイトには不可欠だったのです。
Amazonのアソシエイトとして、当メディアは適格販売により収入を得ています。
理想の辞書ページ構成:15の必須項目と情報設計
サイトの技術的な基盤を整えるのと並行して、最も時間をかけて検討したのが、辞書の「1ページあたりに掲載する情報(データモデル)」の設計です。Web上の辞書の中には、用語とわずか2〜3行の簡素な説明文だけで構成されているサイトも少なくありません。しかし、それでは読者の深い知的好奇心を満たすことはできず、検索エンジンの品質評価(検索意図の充足)にも耐えられません。
逆に、情報があまりにも煩雑に散らばっていれば、スマートフォンなどの限られた画面幅において可読性が著しく低下します。「シンプルでありながら、学術的な専門性や検索ニーズの多様性にも耐えうるデータモデル」を目指し、試行錯誤の末に導き出したのが、以下の「15の必須項目」です。
| 項目名 | 役割・内容 | 導入の狙い・SEO効果 |
|---|---|---|
| 1. 用語名(見出し) | 言葉の一般的な正式表記(漢字・ひらがな・カタカナ等) | 第一認識の確立、h1タグおよびタイトルタグへの配置 |
| 2. 読み仮名 | ひらがな・アルファベットでの正式な読み方 | 五十音順インデックス生成、音声読み上げ、表記揺れ対応 |
| 3. 国際音声記号(IPA) | 世界標準の国際音声記号による厳密な発音表記 | 学術的信頼性の担保、言語学習者や多言語ユーザーへの配慮 |
| 4. 簡潔な定義 | 一目で本質が伝わる60〜100文字程度の要約 | ファーストビューでの疑問解消、検索スニペット・SNSシェア時の視認性 |
| 5. 詳細な解説 | 言葉の背景、メカニズム、現代社会での使われ方 | 網羅的な理解の促進、長文読解ニーズの充足、滞在時間の延伸 |
| 6. 語源・由来 | 言葉が誕生した歴史的経緯、原語の語源情報 | 知的好奇心を刺激する情報価値、他サイトとの明確な差別化 |
| 7. 日本十進分類法(NDC) | 図書館等で採用されている体系的な3桁〜4桁の分類コード | 客観的・学術的な知識ツリーの構築、関連分野への系統的リンク |
| 8. カテゴリー・タグ | Webサイト独自の大分類・中分類・小分類 | サイト内回遊の促進、トピッククラスター構造の自動生成 |
| 9. 類義語・同義語 | 似た意味を持つ言葉への内部リンクと簡単な比較 | 回遊率向上、文脈の微細なニュアンス理解の補助 |
| 10. 対義語・反意語 | 反対の意味を持つ言葉への内部リンク | 対比構造による概念理解の深化、内部リンク網の強化 |
| 11. 用例・例文 | 実際の日常会話や学術・ビジネス文章での使用例 | 実践的な言葉の使い方の提示、検索意図の深掘り |
| 12. 英語表記・外国語訳 | 対応する英語表記および主要外国語(原語)の綴り | 外国文献調査への足がかり、グローバルな検索ニーズへの対応 |
| 13. 関連する人物・歴史 | 言葉の提唱者、代表的な研究者、関係する歴史的事件 | 歴史的コンテキストの付与、人物記事とのクロスリンク |
| 14. 参考文献・情報源 | 定義の根拠となった公的資料、論文、学術書籍 | E-E-A-T(専門性・経験・権威性・信頼性)の強力な担保 |
| 15. 更新日・バージョン | 情報の最終検証日およびデータスキーマのバージョン | コンテンツの鮮度保証、検索エンジンクローラーへの更新通知 |
学術的な信頼性を担保するNDC分類とIPA(国際音声記号)
一般的なWeb用語集や個人ブログと本辞書サイトを明確に分かつ最大の差別化ポイントが、「日本十進分類法(NDC)」と「国際音声記号(IPA)」の採用です。
インターネット上の多くの辞書は、サイト運営者の主観による「ビジネス」「ライフスタイル」「IT」といった大雑把な独自カテゴリだけで整理されているケースが大半です。しかし、日本の図書館界で100年近く磨き上げられてきた「日本十進分類法(NDC: Nippon Decimal Classification)」を導入することにより、あらゆる概念が学術的・体系的な階層構造の中に過不足なく位置付けられます。
NDCコードが付与されていれば、ユーザーはその言葉がどの学問体系(哲学なのか、自然科学なのか、産業なのか)に属しているかを即座に把握できます。さらに、図書館の蔵書検索(OPAC)や国会図書館のデータベースともシームレスに概念が繋がり、より専門的な原典資料へアクセスするための「学術のハブ」として機能するようになります。
また、IPA(International Phonetic Alphabet)の発音表記を添えることで、カタカナ表記では再現しきれない母音の長短や子音の調音位置が厳密に伝わります。これは日本語話者だけでなく、日本語を学ぶ外国人学習者や、将来的に音声合成・読み上げAIなどのアクセシビリティ機能を拡充する際にも不可欠なデータ基盤となります。
構造化データ(Schema.org)による検索エンジンへの最適化
15の項目をHTMLとして見栄えよく整えるだけでなく、検索エンジンのクローラー(Googlebotなど)やLLM(大規模言語モデル)のクローラーが機械可読な形で理解できるように、各ページに Schema.org の構造化マークアップを実装しました。辞書コンテンツに最も適したスキーマタイプである DefinedTerm および DefinedTermSet を採用しています。
{
  "@context": "https://schema.org",
  "@type": "DefinedTerm",
  "name": "リンゴ",
  "termCode": "625.21",
  "description": "バラ科リンゴ属の落葉高木樹、またはその果実。仁果類を代表する果樹。",
  "inDefinedTermSet": {
    "@type": "DefinedTermSet",
    "name": "日本十進分類法(新訂10版)",
    "url": "https://example.com/ndc/625"
  }
}
このようにJSON-LD形式で用語コード(NDC)や定義を明示することで、検索結果のリッチリザルト(強調スニペット)への露出確率が大幅に向上し、AI検索エンジンからの参照元としての信頼度を高める設計にしています。
ユーザーの回遊性を高めるUI/UX設計(サイドバー、検索窓、カテゴリ)
1万ページもの膨大なアーカイブが存在していても、読者が目的の言葉にストレスなく辿り着けなければ、サイトの価値は半減してしまいます。本プロジェクトでは、画面の広さに応じたレスポンシブな動線を以下のように構築しました。
- リアルタイム・インクリメンタル検索窓: ヘッダーに常設された検索窓から、1文字入力するごとに候補語がミリ秒単位で絞り込まれる快適な検索体験。
- 階層型NDCアコーディオンメニュー: デスクトップの左サイドバーに、NDCの類(1桁)・綱(2桁)・目(3桁)をツリー状に展開できる階層ナビゲーションを配置。
- 偶発的な学びを生む「今日の言葉」&「ランダム抽出」: 辞書を目的なく眺めている読者にも新しい発見(セレンディピティ)を提供するため、日替わりのピックアップ用語やランダム遷移ボタンを設置。
最新フレームワーク「Astro v6」の選定とContent Layerへの移行
1万ページという大規模なコンテンツを静的ビルドし、最速のレスポンスを実現するために、フロントエンドフレームワークの選定には細心の注意を払いました。最終的に選択したのが、コンポーネント指向でありながら徹底した静的HTML出力を掲げるAstro(最新のバージョン6)です。
なぜ辞書サイトにAstroが最適なのか?(静的生成とゼロJSの強み)
近年のフロントエンド開発では、Next.jsやNuxtなどのフルスタックReact/Vueフレームワークが人気を博しています。しかし、これらのフレームワークはデフォルトでクライアントサイドに大量のJavaScriptランタイムを配信し、ハイドレーション(Hydration)処理を実行します。
辞書サイトの9割以上の領域は「文章を閲覧するための静的なテキスト情報」です。そこに重厚なJavaScriptランタイムを読み込ませることは、モバイル端末のメモリ消費を増やし、初期ローディング速度(Core Web VitalsのINPやLCP)を劣化させる原因にしかなりません。
Astroは「アイランドアーキテクチャ(Islands Architecture)」を採用しており、インタラクティブなUI(検索窓やアコーディオンなど)が存在する部分だけを独立した「島(Island)」としてJavaScriptを配信し、それ以外のページ全体は「純粋なHTMLとCSSのみ」を出力します。これにより、1万ページの超軽量な静的ファイルが生成され、CDNから瞬時に読者へと届けられるのです。
レガシー仕様からの脱却:src/content.config.tsとloader機能の解説
しかし、Astroのメジャーアップデートに伴い、開発初期に大きな壁に直面しました。従来のAstro(v2〜v4系)で標準仕様だった src/content/config.ts によるコンテンツコレクション定義が、最新仕様では「レガシー(旧形式)」として扱われ、ビルドエラーで停止してしまったのです。
調査の結果、Astroは大規模コンテンツのデータパイプラインを根本から再設計した次世代のデータ管理機構「Content Layer」を標準搭載したことが分かりました。従来のコンテンツコレクションは、ローカルの src/content/ ディレクトリに置かれたMarkdown/MDXファイルを読み込むことしか想定されていませんでした。そのため、数千〜1万件を超えるファイル数になると、ビルド時のメモリ消費が増大し、開発サーバーの起動が遅くなるというボトルネックを抱えていたのです。
新設されたContent Layerでは、設定ファイルの配置場所がルート直下の src/content.config.ts へと変更され、新機能である loader APIを介してデータを柔軟に取り込む仕組みに刷新されました。
Content Layerの革新的な強み:
・データソースの完全な抽象化: ローカルのMarkdownファイルだけでなく、外部REST API、GraphQL、ヘッドレスCMS、さらには巨大なJSON/CSVファイルやローカルSQLiteデータベースからでも、同一のAPI(getCollection)でデータを取得可能。
・高速な差分キャッシュ: データを内部ストレージにキャッシュし、変更のあったファイルのみを差分ビルドするため、1万件のデータがあっても開発サーバーの起動やリビルドが瞬時に完了。
実装コード:src/content.config.tsによる15項目のZodスキーマ定義
以下は、実際に本プロジェクトで構築した src/content.config.ts の設定コードです。astro/loaders から提供される glob ローダーを使用し、15項目のデータスキーマをZodによって厳密に型定義しています。
import { defineCollection, z } from 'astro:content';
import { glob } from 'astro/loaders';

const dictionary = defineCollection({
  // Content Layerのglobローダーを使用してMarkdownファイルを高速走査
  loader: glob({ pattern: '**/*.md', base: './src/data/dictionary' }),
  schema: z.object({
    title: z.string().describe('用語名'),
    reading: z.string().describe('読み仮名'),
    ipa: z.string().describe('国際音声記号'),
    summary: z.string().max(120).describe('簡潔な定義(120文字以内)'),
    ndc: z.string().regex(/^\d{3}(\.\d+)?$/, '正しいNDC形式で入力してください').describe('日本十進分類法コード'),
    category: z.array(z.string()).describe('カテゴリ分類'),
    tags: z.array(z.string()).default([]).describe('タグ一覧'),
    synonyms: z.array(z.string()).default([]).describe('類義語'),
    antonyms: z.array(z.string()).default([]).describe('対義語'),
    examples: z.array(z.string()).describe('用例リスト'),
    english: z.string().describe('英語表記'),
    relatedFigures: z.array(z.string()).default([]).describe('関連する人物・歴史'),
    references: z.array(z.object({
      title: z.string(),
      url: z.string().url().optional(),
    })).describe('参考文献リスト'),
    updatedAt: z.coerce.date().describe('最終更新日'),
    version: z.string().default('1.0.0').describe('データバージョン'),
  }),
});

export const collections = { dictionary };
このようにZodでバリデーションルールを記述しておくことで、1万語のデータの中に「NDCの形式不正」や「必須項目の入力漏れ」があった場合、ビルド時に即座にコンパイルエラーとして検知できるようになりました。
開発現場で直面した技術的トラブルと解決手順
最新の技術スタックを導入する開発では、公式ドキュメントの記述が追いついていなかったり、OS固有のコマンド挙動によって思わぬエラーに遭遇することが日常茶飯事です。今回の辞書サイト基盤構築においても、解決までに長時間を要した深刻なトラブルがいくつか発生しました。ここでは、その実例と具体的な解決手順を記録します。
TypeScriptの型定義(astro:content)エラーを解消する「npx astro sync」の威力
Content Layerへの移行作業中、最も開発者を悩ませたのが、エディタ(VS Code)上で astro:content モジュールをインポートしようとした際に発生した「モジュールが見つからない、または型定義が存在しません」というTypeScriptのコンパイルエラーでした。
src/content.config.ts には一寸の狂いもなくスキーマを記述しているにもかかわらず、ページテンプレート(.astro ファイル)側で getCollection('dictionary') を呼び出すと、すべての戻り値が any 型になってしまったり、赤い波線で警告が表示されてしまう状態に陥りました。
この原因は、Astroの内部機構にありました。Astroは、ユーザーが定義したスキーマファイルをバックグラウンドで解析し、プロジェクトルートの .astro/types.d.ts という隠しファイルに動的な型定義を自動生成する仕組みを持っています。しかし、設定ファイルを移動したり、フレームワークのキャッシュが残っている状態では、この型生成処理が自動でトリガーされないケースがあるのです。
この型定義の不整合を一撃で解消する魔法のコマンドが npx astro sync です。
型定義同期のトラブルシューティング手順:
- ターミナルを開き、プロジェクトのルートディレクトリに移動する。
npx astro syncコマンドを実行する。.astro/types.d.tsが再生成され、スキーマに定義した15項目のプロパティ(title,reading,ndcなど)が完全な型補完としてエディタ上で認識される。- もしエディタの警告が消えない場合は、VS Codeのコマンドパレットから「TypeScript: Reload Project」を実行する。
このコマンドによって強固な型安全性が回復し、15項目のプロパティ名を typo(打ち間違い)しただけでもエディタが即座にエラーを指摘してくれる、極めて安心感の高い開発環境が整いました。
Windows PowerShell環境特有のコマンド挙動と開発の落とし穴
開発マシンとしてWindows環境(PowerShell)を利用している場合、Web上の技術記事や公式ガイドに記載されているUNIX系(macOS / Linux)前提のBashコマンドをそのまま貼り付けると、不可解なエラーで弾かれるケースが多発します。
- インライン環境変数の構文エラー:
BashではNODE_ENV=production npm run buildと1行で記述できますが、PowerShellでこれを実行すると「NODE_ENVという用語はコマンドとして認識されていません」というエラーになります。PowerShellでは$env:NODE_ENV="production"; npm run buildと記述するか、クロスプラットフォーム対応ライブラリであるcross-envをpackage.jsonに導入するのがベストプラクティスです。 - スクリプト実行ポリシー(ExecutionPolicy)によるブロック:
新規にセットアップしたWindowsマシンでnpxやnpmスクリプトを実行しようとすると、PSSecurityException(スクリプトの実行が無効になっているため…)が発生して実行が停止することがあります。この場合は、PowerShellを管理者権限で起動し、Set-ExecutionPolicy -ExecutionPolicy RemoteSigned -Scope CurrentUserを実行してスクリプト実行を許可する必要があります。 - パスの区切り文字(スラッシュ問題):
Windowsの標準パスセパレータはバックスラッシュ(\)ですが、AstroのglobローダーやViteのモジュール解決ではフォワードスラッシュ(/)に統一しなければ、ファイルが正しく認識されません。設定ファイル内では常にpath.posix.join()を使うか、明示的にスラッシュでパスを記述することが鉄則です。
1万ページ規模のビルドに備えるNode.jsヒープメモリの最適化
小規模なサイトでは問題になりませんが、ページ数が1万件規模に達すると、ビルドプロセスにおいてNode.jsのデフォルトのメモリ割り当て上限(通常約2GB〜4GB)に達し、JavaScript heap out of memory でクラッシュするリスクが生じます。
この問題への予防策として、package.json のビルドスクリプトにおいて、事前にNode.jsの最大ヒープ領域を拡張しておく設定を施しました。
{
  "scripts": {
    "dev": "astro dev",
    "sync": "astro sync",
    "build": "node --max-old-space-size=8192 ./node_modules/astro/dist/cli/index.js build"
  }
}
ヒープメモリを8GB(8192MB)まで拡張しておくことで、数千〜1万のページ生成時にもメモリ枯渇によるビルド停止を確実に回避できるようになります。
サンプルデータ「リンゴ」による実証テストとレンダリング確認
堅牢なデータスキーマとビルドパイプラインが完成したところで、設計した15項目が実際のブラウザ上で破綻なくレンダリングされるかを検証するため、具体的な実証サンプルデータを作成してテストを行いました。
植物としての「リンゴ」×NDC「625番台(果樹園芸)」の紐付け実践
テスト対象の単語には、IT用語としてのApple社ではなく、自然科学・農業分野の代表的な単語として「リンゴ(林檎)」を選定しました。植物としての学名、日常的な用例、歴史的背景など、多面的な情報構造を検証するのに最適な単語だからです。
ここで極めて重要になるのが、前述した「日本十進分類法(NDC)」の厳密なコード割り当てです。日本図書館協会が公表している現行のNDC新訂10版の体系に基づき、リンゴの分類を以下のように整理しました。
- 600番台: 産業(産業全般、農業、林業、水産業など)
- 620番台: 園芸(園芸学、園芸栽培の総称)
- 625番台: 果樹園芸(くだもの全般の栽培技術と品種)
- 625.2: 仁果類(花托が肥大して果肉となる果実群)
- 625.21: リンゴ(林檎の品種改良、栽培法、特性)
図書館の分類基準において、625番台が「果樹園芸」であり、隣接する626番台は「蔬菜(そさい)園芸=野菜の栽培」に明確に分かれています。もしここでリンゴに626番台を割り当ててしまうと、「リンゴがトマトやキュウリと同じ野菜カテゴリに分類される」という学術的な矛盾が生じてしまいます。
リンゴに正しいコードである「625.21(仁果類・リンゴ)」を付与したことで、将来的に「ナシ(625.22)」と同じ仁果類グループとして自動束ねを行ったり、「ミカン(625.3: 柑橘類)」や「ブドウ(625.61: 液果類)」といった同位の果樹園芸グループと論理的な階層関係を保ったまま内部リンクを生成できることが実証されました。
実証用Markdownファイル(ringo.md)の完全なFrontmatter構成
実際に src/data/dictionary/ringo.md として作成したサンプルデータの内容は以下の通りです。Zodスキーマに適合した完全な構造化Frontmatterとして記述しています。
---
title: "リンゴ"
reading: "りんご"
ipa: "/ɾiŋɡo/"
summary: "バラ科リンゴ属の落葉高木樹、またはその果実。生食のほかジュースやアップルパイなど加工用途も広い仁果類を代表する果物。"
ndc: "625.21"
category:
  - "自然科学"
  - "農学・園芸"
tags:
  - "果物"
  - "落葉樹"
  - "仁果類"
synonyms:
  - "林檎"
  - "セイヨウリンゴ"
antonyms: []
examples:
  - "毎朝の習慣として、新鮮なリンゴを皮ごと一個食べる。"
  - "青森県や長野県は、日本有数のリンゴの特産地として知られている。"
english: "Apple (Malus domestica)"
relatedFigures:
  - "アイザック・ニュートン(万有引力の逸話)"
  - "ジョン・チャップマン(ジョニー・アップルシード)"
references:
  - title: "日本十進分類法 新訂10版(日本図書館協会)"
    url: "https://www.jla.or.jp/"
  - title: "農林水産省 作物統計調査(果樹)"
    url: "https://www.maff.go.jp/"
updatedAt: 2026-10-30
version: "1.0.0"
---

## 詳細解説
リンゴ(学名:*Malus domestica*)は、中央アジアの天山山脈周辺を原産地とするバラ科の落葉高木です。紀元前から栽培が行われており、シルクロードを経て東西へと伝播しました。日本には明治時代初期に西洋リンゴが導入され、気候に適した東北地方を中心に本格的な品種改良が進められました。

果実は主に食用とされ、ビタミンC、カリウム、食物繊維(ペクチン)、ポリフェノール類を豊富に含んでいます。「1日1個のリンゴは医者を遠ざける」という西洋のことわざがあるように、高い栄養価と機能性を併せ持つ果物として世界中で親しまれています。

## 語源・由来
和名「りんご」は、平安時代の文献に見られる中国語「林檎(りむきん/りんきん)」が転訛した言葉とされています。「林の中に集まる鳥たちが好んで食べる果実」という情景に由来すると言われており、当時は現在の西洋リンゴとは異なる小粒で酸味の強い和リンゴ(ワリンゴ)を指していました。
15項目が破綻なく表示される「器」の検証結果
ローカル開発サーバー(localhost:4321)を起動し、作成した ringo.md のレンダリング結果をブラウザで精査しました。
- ヘッダーエリアのタイポグラフィ: 大見出しの「リンゴ」の脇に、淡いグレーで読み仮名「りんご」、そして国際音声記号「/ɾiŋɡo/」と学名が美しいバランスで並び、文字の視認性が極めて高い。
- 要約定義のファーストビュー配置: 検索流入したユーザーが最初に目にする位置に、要約された定義文(サマリー)がハイライト枠で強調表示され、離脱を防ぐ構成になっている。
- NDCパンくずリストの正確なリンク構造: ページ上部に「産業 (600) > 園芸 (620) > 果樹園芸 (625) > 仁果類 (625.2) > リンゴ (625.21)」という体系的なパンくずリストが自動生成され、クリックひとつで親カテゴリや関連果樹へ遷移可能。
- メタ情報パネルの分離: 画面右側(スマホでは本文下部)に、英語表記、用例、関連人物、参考文献、最終更新日などの属性情報がカード型コンポーネントとしてすっきりと整理されている。
Google ChromeのLighthouseツールを用いてページパフォーマンスを測定したところ、Performance: 100点、Accessibility: 100点、Best Practices: 100点、SEO: 100点という満点スコアを記録しました。不要なJavaScriptを一切読み込まないAstroの真価が遺憾なく発揮された結果です。
次のステップ:1万語の一括生成とPagefindによる超高速検索
15項目を美しく描画する「器(デザインコンポーネントとデータスキーマ)」の検証が完了したことで、本プロジェクトは次のステージ――「1万語のコンテンツ量産」と「超高速な静的検索エンジンの構築」へと進みます。
手作業の限界を打破するCSV/Markdown自動生成パイプライン
1万件という途方もない数の辞書データを、人間がエディタを開いて1ファイルずつ手作業で執筆・保存することは不可能です。もし1語の作成・校正に平均15分かかったと仮定すると、10,000語を完了するには約2,500時間(1日8時間作業しても約312日)という膨大な時間を要します。
そこで次なる課題は、外部の構造化データベース(オープンデータ、学術アーカイブ、スプレッドシート等)から取得した用語リストと属性データを中間CSVファイルに集約し、Node.jsまたはPythonスクリプトを用いて一括でMarkdownファイルを自動生成するパイプラインの構築です。
// データ生成スクリプトの概念例(generate-markdown.mjs)
import fs from 'fs';
import path from 'path';
import { parse } from 'csv-parse/sync';

const csvData = fs.readFileSync('./raw-dictionary.csv', 'utf-8');
const records = parse(csvData, { columns: true, skip_empty_lines: true });

records.forEach((record) => {
  const frontmatter = `---
title: "${record.title}"
reading: "${record.reading}"
ipa: "${record.ipa}"
summary: "${record.summary.replace(/"/g, '\\"')}"
ndc: "${record.ndc}"
category: ${JSON.stringify(record.categories.split(','))}
english: "${record.english}"
updatedAt: ${new Date().toISOString().split('T')[0]}
---

## 詳細解説
${record.description}
`;

  const fileName = `${record.slug || record.title}.md`;
  fs.writeFileSync(path.join('./src/data/dictionary', fileName), frontmatter);
});

console.log(`${records.length}件のMarkdownファイルを一括生成しました。`);
この自動化パイプラインにZodバリデーションを組み込むことで、生成と同時にデータの不備や欠損を自動検知し、品質の担保された1万ページのMarkdown群をわずか数分で生成できるようになります。
静的サイトと抜群の相性を誇る検索エンジン「Pagefind」の導入展望
辞書サイトにおいて、読者が目的の言葉を瞬時に探し出せる「検索機能」はサイトの生命線です。しかし、1万件ものページが存在する静的サイトで検索をどう実現するかは、長年Webエンジニアを悩ませてきた難問でした。
一般的なWebサイトで検索機能を実装する場合、サーバーサイドにElasticsearchやMySQLなどのデータベースを配置してAPI経由で問い合わせるのが定石です。しかし、これではサーバーの常時稼働コストが発生し、サーバーダウンのリスクも抱えるため、静的サイトの最大のメリットである「ゼロインフラ・高耐久性」が崩れてしまいます。
一方で、従来のクライアントサイド検索ライブラリ(Lunr.jsやFlexSearchなど)は、サイト全体の全検索インデックス(巨大な単一のJSONファイル)をユーザーのブラウザに一括ダウンロードさせる仕組みでした。ページ数が1万件を超えると、インデックスファイルのサイズが数十MBに膨れ上がり、スマートフォンでの通信量圧迫やブラウザのフリーズを引き起こしてしまいます。
このジレンマを完全に解決するのが、静的サイト専用に設計された次世代の検索ライブラリ「Pagefind」です。
| 比較項目 | 従来のクライアント検索(Lunr.js等) | Pagefind(静的特化インデックス) |
|---|---|---|
| インデックス生成手法 | ビルド時に全データを単一JSONとして書き出し | ビルド後のHTMLを解析し、細かく分割された静的チャンクを生成 |
| ブラウザの通信量 | 初回アクセス時に数MB〜数十MBを一括ダウンロード | 検索キーワードに関連する断片チャンクのみ取得(数十KB〜数百KB) |
| 1万件での検索応答速度 | メモリ消費大、端末によっては動作が極めて重い | WebAssembly(Wasm)を活用し、数十ミリ秒以内で爆速応答 |
| サーバーインフラ費用 | 不要(ブラウザ処理) | 完全不要(静的ホスティングのファイル配信のみで完結) |
| 日本語(CJK)対応 | 形態素解析ライブラリ(kuromoji.js等)の追加が必要 | 多言語サポートが内蔵されており、中国語・日本語・韓国語に対応 |
| 導入の手軽さ | 検索用インデックスの構築コードを自前で実装 | ビルド後に npx pagefind --site dist を走らせるだけで完結 |
Pagefindは、Rustで書かれた超高速なインデクサーがビルド出力ディレクトリ(dist/)のHTMLを直接解析し、検索インデックスを数百個の小さなバイナリファイル(チャンク)に分割して保存します。ブラウザ上で検索窓に入力された際、入力文字に関連するチャンクファイルだけをオンデマンドで取得してWebAssembly上で高速照合するため、1万ページ規模のサイトであっても通信量とメモリ消費を最小限に抑え、ミリ秒単位の爆速検索を実現できるのです。
よくある質問(FAQ):大規模辞書サイト構築について
- Q1. 1万ページの静的サイトをビルドすると、ビルド時間はどれくらいかかりますか?
-
マシンスペックや画像最適化処理の有無によって前後しますが、Astro v6のContent Layerと最新のVite環境であれば、一般的なPC環境で数分から十数分程度でビルドを完了できます。また、Content Layerはコンテンツのハッシュ値を保持して変更のないファイルをスキップする差分キャッシュ機構を備えているため、開発中のローカルサーバー起動や再ビルドは数秒で完了します。
- Q2. ホスティング先(サーバー環境)はどこが最もおすすめですか?
-
完全な静的HTMLおよび静的アセットとして出力されるため、Cloudflare Pages、Vercel、Netlifyなどのモダンなエッジホスティングが最適です。特にCloudflare Pagesは、帯域幅(転送量)が無制限・無料で利用できるプランが充実しており、世界300都市以上のエッジデータセンターから数万ページの辞書コンテンツを超高速・耐障害性高く配信できるため、個人開発のインフラとして最も推奨されます。
- Q3. なぜ最初からSupabaseやFirebaseなどのBaaS・データベースを使わないのですか?
-
辞書サイトは「書き込み頻度が低く、読み取り頻度が極めて高い」という典型的なリードヘビー(Read-Heavy)な特性を持ちます。データベースを介してページを表示する構成にすると、アクセスごとにDB接続コストやクエリレイテンシが発生し、無料枠の上限到達や従量課金のリスクが常に付きまといます。全コンテンツを静的ファイルとしてビルドしておけば、データベースのダウンタイムに怯える必要がなく、ランニングコストを恒久的にほぼゼロに抑えられるためです。
- Q4. 1万語のデータ管理において、表記揺れや誤記のチェックはどう行いますか?
-
本記事で紹介したZodスキーマによる型バリデーションに加え、CI(GitHub Actions)パイプライン上で
textlintやcspellなどの文章校正・スペルチェッカーを自動実行する仕組みを導入します。これにより、プルリクエストを出した段階で、NDCコードの形式不備、必須項目の欠損、不自然な日本語表記を自動的にブロックし、辞書としての学術的品質を保ちます。 - Q5. 将来的に多言語(英語・中国語等)への展開や音声発音の追加は可能ですか?
-
十分に可能です。Astroは強力な国際化(i18n)ルーティング機能を標準でサポートしています。また、本設計では既に「英語表記」や「国際音声記号(IPA)」をスキーマの必須項目として組み込んでいるため、各単語の音声ファイル(mp3/ogg)へのパスをFrontmatterに追加するだけで、音声再生ボタンを備えたマルチリンガル辞書へとスムーズに拡張できます。
まとめ:知識の海を誰もが自由に渡れるプラットフォームへ
個人で「1万語のデジタル辞書サイトを作る」という構想は、一見すると無謀な挑戦に思えるかもしれません。しかし、論理的な情報設計(15の必須項目とNDC新訂10版による分類体系)と、最先端のモダンフロントエンド技術(Astro v6 Content LayerとPagefind)を掛け合わせることにより、個人開発でも十分に大手出版社に匹敵するナレッジベースを構築できる現実的な道筋が見えてきました。
Content Layerへの移行によるTypeScript型エラーを npx astro sync で解消し、PowerShell環境でのクロスプラットフォームの癖を乗り越え、実証サンプル「リンゴ」によるNDC 625番台(果樹園芸)の正確なマッピングとレンダリング検証を完了した今、辞書サイトとしての「強固な骨格」は確実に完成しました。
次回は、いよいよ数千〜1万件の構造化データを一括変換する自動生成スクリプトの実践と、Pagefindを組み込んだ爆速インクリメンタル検索の実装記録をお届けします。知識の海を誰もが自由に、そして深く探索できるプラットフォームの完成を目指し、開発の歩みを進めていきます。